
Советы по программированию на ИИ. Лайфхаки для разработчиков.
Руководители ИТ-подразделений всё чаще задают нам один и тот же вопрос. Как встроить ИИ-ассистентов в работу разработчиков так, чтобы скорость росла, а качество, безопасность и контроль не страдали? Мы собрали практические правила по каждому этапу: постановка задачи, работа с контекстом, проверка результата, ограничения, требования к безопасности и чек-лист для пилота.
Короткий ответ такой. Программировать с ИИ значит ставить нейросети задачу как исполнителю, а результат проверять как ревьюер. ИИ помогает программировать быстрее на рутине: пишет шаблонный код, тесты, документацию, объясняет чужой код и предлагает гипотезы при отладке. Задачу описывают конкретно: язык и версия, входные и выходные данные, ограничения.
Крупную задачу дробят на шаги, модели передают только нужный контекст, сначала просят план и лишь потом код. Каждый фрагмент тестируют, а то, что команда не понимает, в работу не отправляют. Конфиденциальные данные в публичные сервисы не передают.
Подход, при котором программа пишется в основном по описанию на естественном языке, называют вайб-кодингом (vibe coding, или кодингом по описанию). Это значит, что кодинг начинается с формулировки намерения словами, а реализацию предлагает нейросеть.
Возникает закономерное возражение: разработчики и так пользуются ИИ, зачем отдельные правила? Без единых правил каждый работает по-своему: один вставляет в публичный чат фрагменты закрытого репозитория, другой принимает подсказки без ревью. Риски по утечкам и качеству в итоге ложатся на ИТ-руководителя.
Какие задачи разработки стоит отдавать ИИ, а какие нет
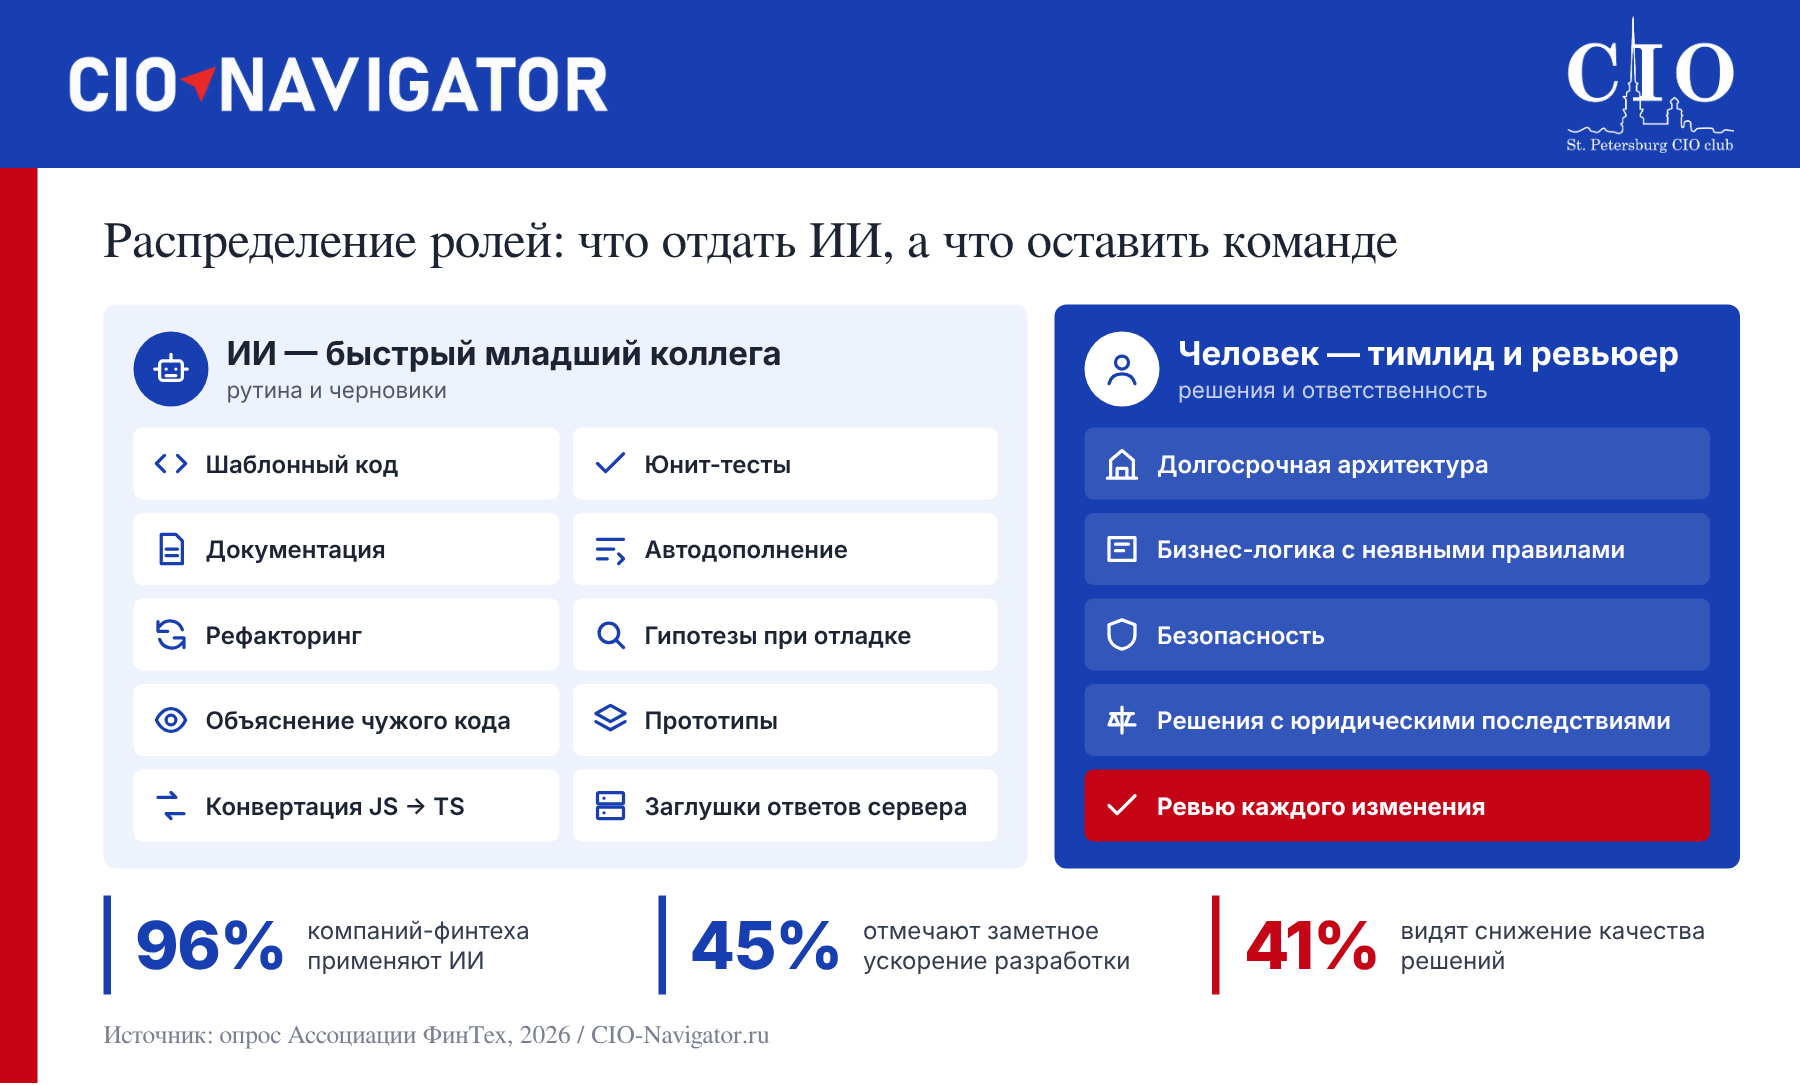
При использовании ИИ для программирования удобная схема распределения ролей выглядит так: нейросеть работает как быстрый младший коллега, а человек выступает тимлидом и ревьюером. В таблице ниже собраны топ типовых сценариев и показано, как эта схема в них работает:
| Сценарий | Роль нейросети | Контроль человека |
|---|---|---|
| Шаблонный код: CRUD-операции, парсеры, типовые интерфейсы | Пишет заготовку по описанию | Ревью перед слиянием |
| Автодополнение в IDE | Предлагает продолжение строки или блока | Каждая подсказка принимается осознанно |
| Поиск причины ошибки по тексту исключения | Выдвигает гипотезы | Воспроизведение и подтверждение причины |
| Объяснение чужого или унаследованного кода | Описывает логику и зависимости | Сверка с документацией |
| Рефакторинг и оптимизация | Упрощает структуру, убирает дубли | Прогон тестов до и после изменений |
| Юнит-тесты | Генерирует проверки, включая граничные значения | Оценка соответствия реальным требованиям |
| Документация и комментарии | Описывает функции и параметры | Выборочная вычитка |
| Конвертация между языками, например JavaScript в TypeScript | Переносит синтаксис и типы | Проверка поведения и типизации |
| Имитация ответов сервера | Готовит заглушки, включая ответы с ошибками | Сверка с контрактом API |
| Прототипирование | Собирает черновик идеи | В рабочую среду прототип попадает только после переработки |
Есть зоны, где искусственный интеллект для программирования не заменяет человека: долгосрочная архитектура, бизнес-логика с неявными правилами, безопасность и решения с юридическими последствиями. Нейросети для написания кода, в том числе нейросеть для кода, не знают контекста компании, если его не передали, и не несут ответственности за последствия.
Не менее важно, что нейросеть не «понимает» задачу, а предсказывает вероятное продолжение текста. Поэтому она может выдать уверенный, но неверный ответ: выдуманную библиотеку, устаревший метод или поверхностное решение без обработки ошибок. Результат работы генератора кода также может отличаться даже при одинаковом запросе, так как зависит от модели и контекста диалога.
По нашим наблюдениям, с помощью ИИ выигрыш заметнее всего на рутине и прототипах. На сложных долгоживущих системах без выстроенного ревью ошибки накапливаются незаметно: каждая правка по отдельности выглядит разумной, а вместе они постепенно размывают архитектуру. ИИ ускоряет реализацию, но ответственность за архитектуру и итоговый результат остаётся у команды.
Эту двойственность подтверждают и отраслевые данные. В опросе Ассоциации ФинТех 96% компаний-участников рассказывали о применении ИИ в разработке: 44% используют его активно, остальные проводят пилоты. При этом 45% участников считают, что ИИ существенно ускоряет разработку, а 41% одновременно отмечают снижение качества решений.
Как попросить ИИ написать код: структура запроса
При работе с ИИ для написания кода промпт — это текстовое задание для модели и основа пошагового взаимодействия. Это краткое руководство (гайд) по составлению запроса: чем меньше в нём недосказанного, тем меньше ассистент додумывает за разработчика. В хорошем запросе обычно есть следующие элементы:
- Язык, версия и фреймворк, например Python 3.12 и FastAPI;
- Среда выполнения: браузер, сервер или терминал;
- Формат входа и выхода;
- Ограничения: только стандартная библиотека, запрет устаревших методов, стиль оформления (например, PEP 8);
- Обработка ошибок и поведение при некорректном вводе;
- Примеры входа и ожидаемого выхода;
- Формат ответа: только реализация или реализация с пояснениями;
- Способ проверки: тестовые примеры и команда запуска.
Разницу между слабой и сильной постановкой хорошо видно на двух примерах: точное описание помогает получить нужный результат, когда нейросеть напишет код по заданным условиям.
| Было | Стало |
|---|---|
| «Напиши парсер логов» | «Python 3.12, только стандартная библиотека. На входе лог nginx в формате combined, на выходе CSV с полями ip, время, статус. Битые строки пропускай и подсчитывай. Пример строки и ожидаемого результата прилагаю. Верни функцию и тесты pytest» |
| «Сделай API для заказов» | «FastAPI, эндпоинт GET /orders/{id}, ответ в JSON по приложенной схеме, статус 404 при отсутствии заказа. Сначала опиши план и затрагиваемые файлы» |
Второй пример показывает приём «сначала план, потом реализация» и наглядно объясняет, как использовать ИИ в программировании: ассистент описывает шаги и файлы, которые собирается изменить, до того, как нейросеть пишет код; команда утверждает план, и только после этого начинается генерация. В ряде инструментов для этого предусмотрен отдельный режим планирования; его название и возможности стоит сверить с актуальной документацией.
Для операций, которые что-то меняют, например удаление файлов или запись в базу, стоит отдельно попросить режим пробного запуска (dry run) или работу на копии. Так ошибка в логике проявится до того, как затронет рабочие записи.
Чем точнее запрос, тем меньше итераций правки. Если ответ модели не подходит, полезнее дополнить исходное описание недостающими условиями, чем просить «сделать лучше».
Полезно также попросить ассистента задать уточняющие вопросы до начала работы. Это помогает заранее узнавать, какие допущения в задаче неверны, и экономит время на переделках. Ещё один рабочий приём: попросить модель покритиковать готовое решение или объяснить сложный фрагмент, то есть использовать её как собеседника, а не только как исполнителя.
Декомпозиция и работа с контекстом
Один из практических советов по программированию с ИИ — работать в простом ритме: одна микрозадача, проверка, следующий шаг. Запрос вроде «напиши всё приложение» даёт хрупкий результат, потому что нейросеть вынуждена сама принять десятки решений о структуре, хранении и обработке ошибок, и проверить их разом почти невозможно. Пошаговый план помогает проверять каждый небольшой шаг за минуты.
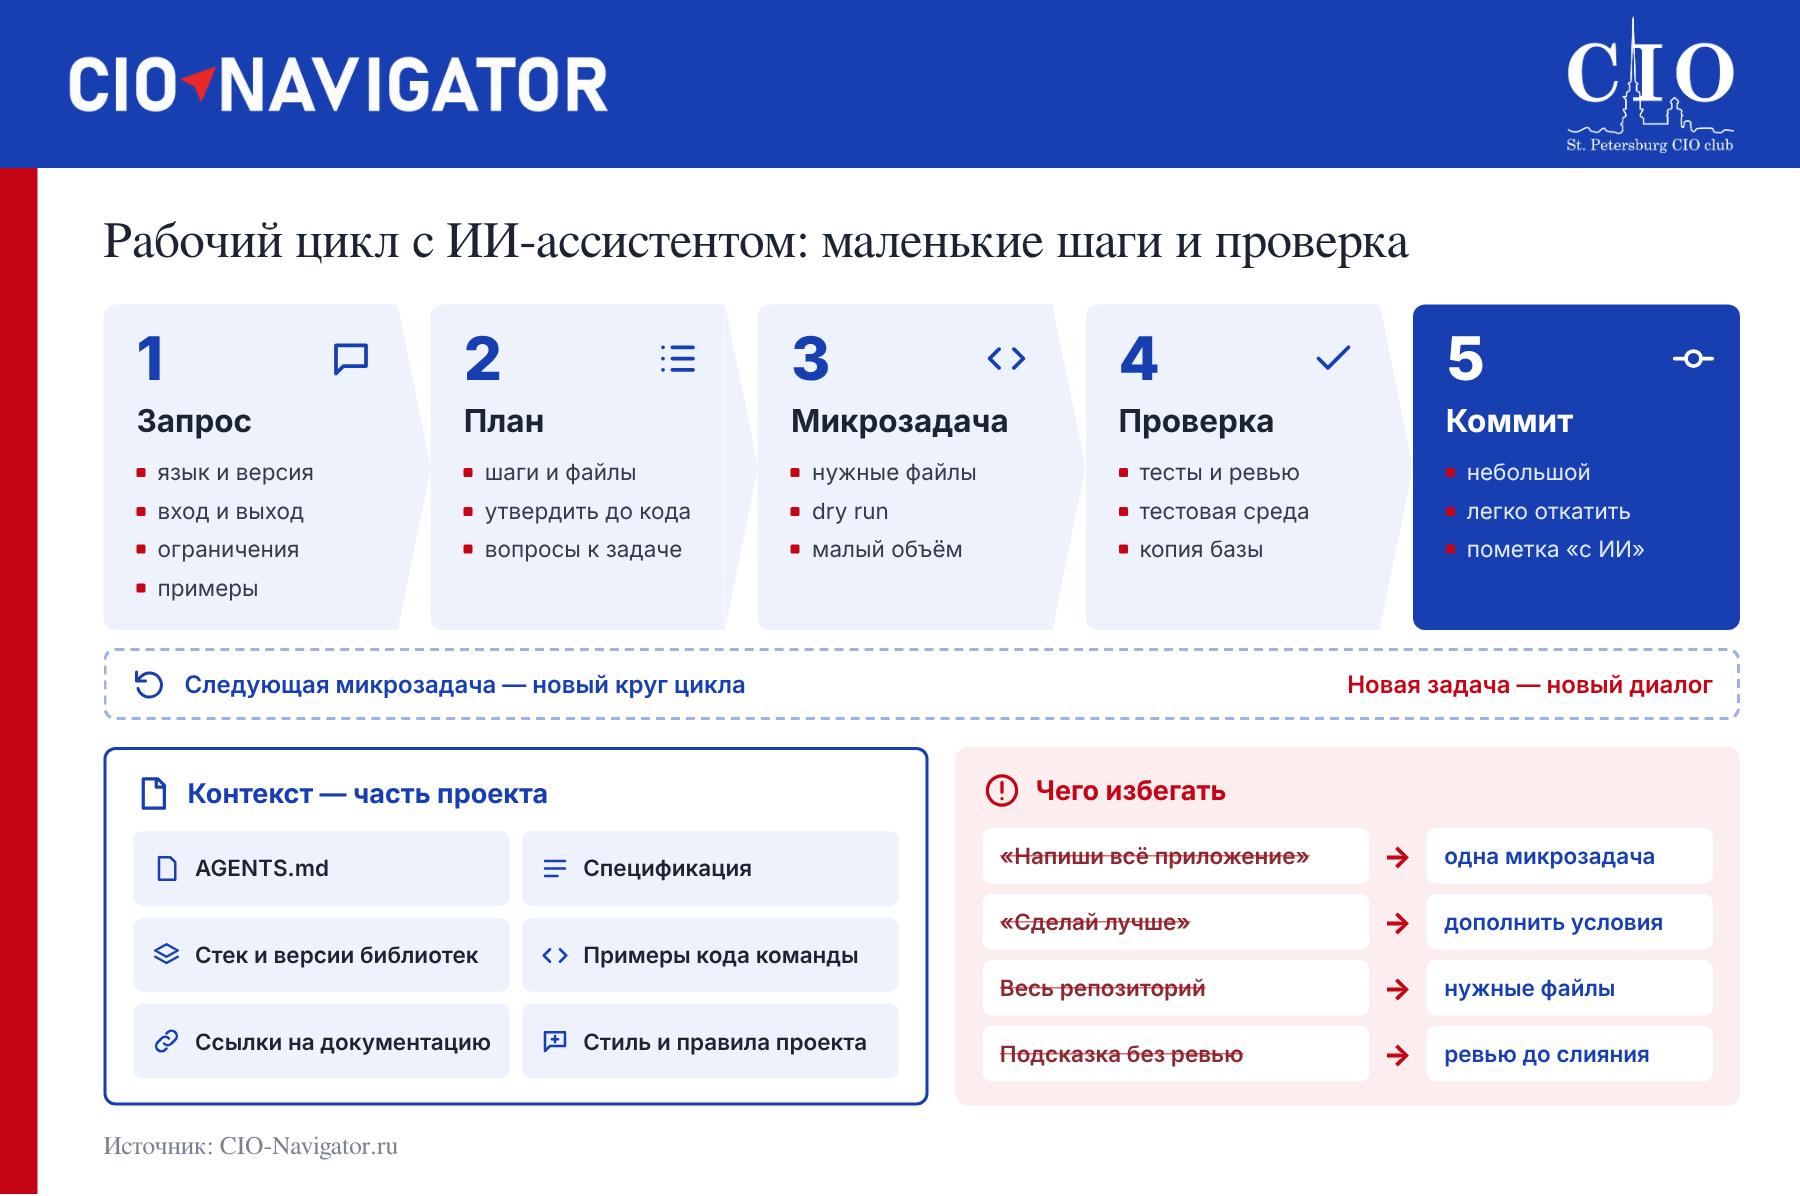
Контекстное окно — это объём текста, который модель учитывает за один раз. Оно ограничено, поэтому в длинных диалогах ранние детали теряются. Снизить потери помогают следующие практики:
- передавать только нужные файлы и функции, а не весь репозиторий;
- хранить правила проекта и стиль в отдельном файле инструкций для ИИ-помощника, или агента, например AGENTS.md (формат зависит от инструмента и уточняется в его документации);
- начинать новую задачу в новом диалоге;
- фиксировать изменения в системе управления версиями VCS небольшими коммитами, чтобы можно было откатиться к рабочей версии.
Плохой контекст выглядит как общая фраза вроде «реализуй сервис уведомлений» или попытка загрузить всю кодовую базу разом. Хороший контекст включает стек и версии библиотек, ссылки на внутреннюю документацию и примеры кода, показывающие принятый в команде способ решения. Если инструмент поддерживает подключение к документации или к запущенному приложению, это тоже стоит проверить на пилоте.
Логичное развитие этих практик называют Spec-Driven Development, то есть разработкой от спецификации. Это значит, что сначала пишется текстовая спецификация с требованиями; в крупных проектах их удобно вести в системах управления требованиями RMS. Создание реализации выполняется на её основе.
На практике первым обычно ломается не отдельная функция, а согласованность между частями системы. Ассистент «забывает» решения, принятые раньше в диалоге, предлагает второй способ обработки ошибок или дублирует существующий модуль. Поэтому мы создаём файл инструкций и спецификацию как часть проекта, а не как вспомогательный текст.
Как проверять код, написанный нейросетью
Здесь работает принцип «ноль доверия». Это значит, что любой сгенерированный фрагмент считается непроверенным, пока не пройдёт те же этапы контроля, что и работа человека. Если никто в команде не может объяснить, что делает фрагмент, он не идёт в работу.
Перед слиянием полезно свериться с рекомендациями в таком чек-листе:
- Сборка и запуск проходят локально;
- Используемые библиотеки и методы существуют в нужной версии: модели подвержены галлюцинациям, то есть уверенно предлагают несуществующие функции или параметры;
- Граничные случаи обработаны: пустые списки, None, некорректные типы;
- В репозитории нет секретов, а сам фрагмент свободен от типовых уязвимостей вроде SQL-инъекций и небезопасной обработки ввода;
- Соблюдён стиль проекта;
- Есть тесты, включая автотесты и сквозные;
- Заимствованные фрагменты лицензионно чисты.
Второй пункт чек-листа особенно важен. Ярослав Старченко, главный ИТ-эксперт редакции Контентим, отмечает, что без достаточного контекста в ИТ-тексте легко допустить фактическую ошибку. Та же проблема возникает при работе с подсказками нейросети: она может предложить устаревший метод, поэтому его статус важно проверять по документации.
При отладке лучше не просить переписать всё заново. Продуктивнее передать полный текст ошибки и попросить минимальное исправление, тогда изменение остаётся обозримым для ревьюера. Часть команд также помечает коммиты и pull request с участием нейросети, чтобы ревьюер знал происхождение изменений; это практика, а не обязательное требование.
Если ассистент зациклился и снова предлагает то же исправление, не продолжайте диалог по кругу. Откройте документацию или онлайн-обсуждения проблемы в репозитории библиотеки, уточните запрос с новыми данными или начните разговор заново. Ответ нередко находится в первоисточнике, а не в очередной итерации подсказок.
Сгенерированные изменения не переносят сразу в рабочую среду. Сначала их проверяют в тестовой среде, а операции с данными прогоняют на копии базы.
Автотесты снимают часть нагрузки с ревью, но здесь мы делаем оговорку. Логические ошибки в бизнес-правилах тесты ловят, только если сами тесты писали люди, понимающие процесс. Проверки, сгенерированные той же моделью по той же реализации, нередко подтверждают её ошибки, а не находят их. В крупных проектах наборы тестов и результаты проверок можно вести в системах управления тестированием TMS.
Ассистента, в том числе ИИ-агента, можно использовать и как дополнительного помощника-ревьюера: попросить его проверить код на уязвимости, лишние зависимости и нежелательные шаблоны. Это помогает убрать очевидные замечания до ревью. Но такая проверка не заменяет специализированные средства анализа и решение человека.
Почему ревью нельзя пропускать, показывает анализ CodeRabbit: в выборке из 470 запросов на внесение изменений в открытый код для запросов с признаками ИИ-соавторства нашли в среднем 10,83 проблемы против 6,45 в запросах без таких признаков. Авторы отмечали ограничение выборки: авторство определяли по косвенным признакам. Поэтому эти цифры не стоит переносить на любую команду.
Безопасность и правила для команды
Для ИТ-руководителя главный вопрос внедрения не в том, какой инструмент точнее, а в том, куда уходит информация. В публичные сервисы нельзя отправлять пароли, API-ключи, токены, персональные данные и фрагменты закрытого кода; это базовое требование информационной безопасности.
Регуляторная часть зависит от статуса организации и характера данных. 152-ФЗ регулирует обработку персональных данных: при их сборе закон ограничивает использование баз за пределами России для записи, систематизации, накопления, хранения, уточнения и извлечения данных граждан РФ, с предусмотренными законом исключениями. Для субъектов КИИ 187-ФЗ устанавливает требования к безопасности значимых объектов, которые дифференцируются по категории значимости; подробнее о категорировании объектов КИИ — в отдельном материале. Поэтому до выбора инструмента стоит проверить применимость норм и требования к конкретной системе вместе с юристами и службой ИБ.
Варианты размещения ассистента различаются местом обработки и вопросами, которые нужно задать поставщику:
| Вариант | Где обрабатывается код | Что стоит проверить |
|---|---|---|
| Публичный облачный сервис | На серверах поставщика, нередко за рубежом | Используются ли запросы для обучения, срок хранения логов, расположение серверов |
| Корпоративный тариф облачного сервиса | На серверах поставщика по договору | Договорные условия об обучении на запросах, хранение логов, локализация, интеграция с IDE и системой контроля версий |
| Размещение в собственном контуре | На серверах компании | Требования к оборудованию, обновление версий, журналирование, интеграция с IDE и системой контроля версий |
Если облачный ассистент обрабатывает персональные данные по поручению компании, в поручении важно закрепить перечень данных, операций и цели обработки, а также условия конфиденциальности и защиты: этого требует 152-ФЗ.
Конкретные продукты, такие как GitHub Copilot, GigaChat, Tabnine, Cursor, Claude Code или ChatGPT, мы в таблицу намеренно не включаем. Их тарифы, в том числе бесплатный доступ, если он предусмотрен, и условия обработки информации меняются, поэтому характеристики стоит сверять с официальными сайтами и до проверки на пилоте воспринимать как заявления вендора.
Во внутренний регламент обычно входят следующие правила:
- Перечень разрешённых инструментов и способов их подключения;
- Запрет на передачу чувствительных данных во внешние сервисы;
- Обязательное ревью всех изменений с участием ИИ;
- Маркировка сгенерированных фрагментов в коммитах или pull request;
- Периодическая работа без ИИ для младших разработчиков, чтобы сохранялись базовые навыки.
Отдельно стоит заложить в регламент обучение. Последний пункт списка связан именно с ним: младшим программистам важно сохранять базовые знания об алгоритмах, структурах данных и работе сети. Без этой базы человек не сможет понять, что и зачем сгенерировала нейросеть, и не сможет исправить ошибку.
Если ассистент встроен в IDE, стоит проверить, какие файлы он автоматически включает в контекст. Запрет в регламенте не сработает, если инструмент сам читает конфигурации с секретами.
Разрыв между использованием ассистентов и контролем за ними пока велик. В исследовании AppSec Solutions и АРПП «Отечественный софт» участвовали более 50 компаний: ИИ-ассистенты кода применяли 72% респондентов, тогда как базовые системы контроля безопасности ИИ внедряли 23% компаний с собственной разработкой.
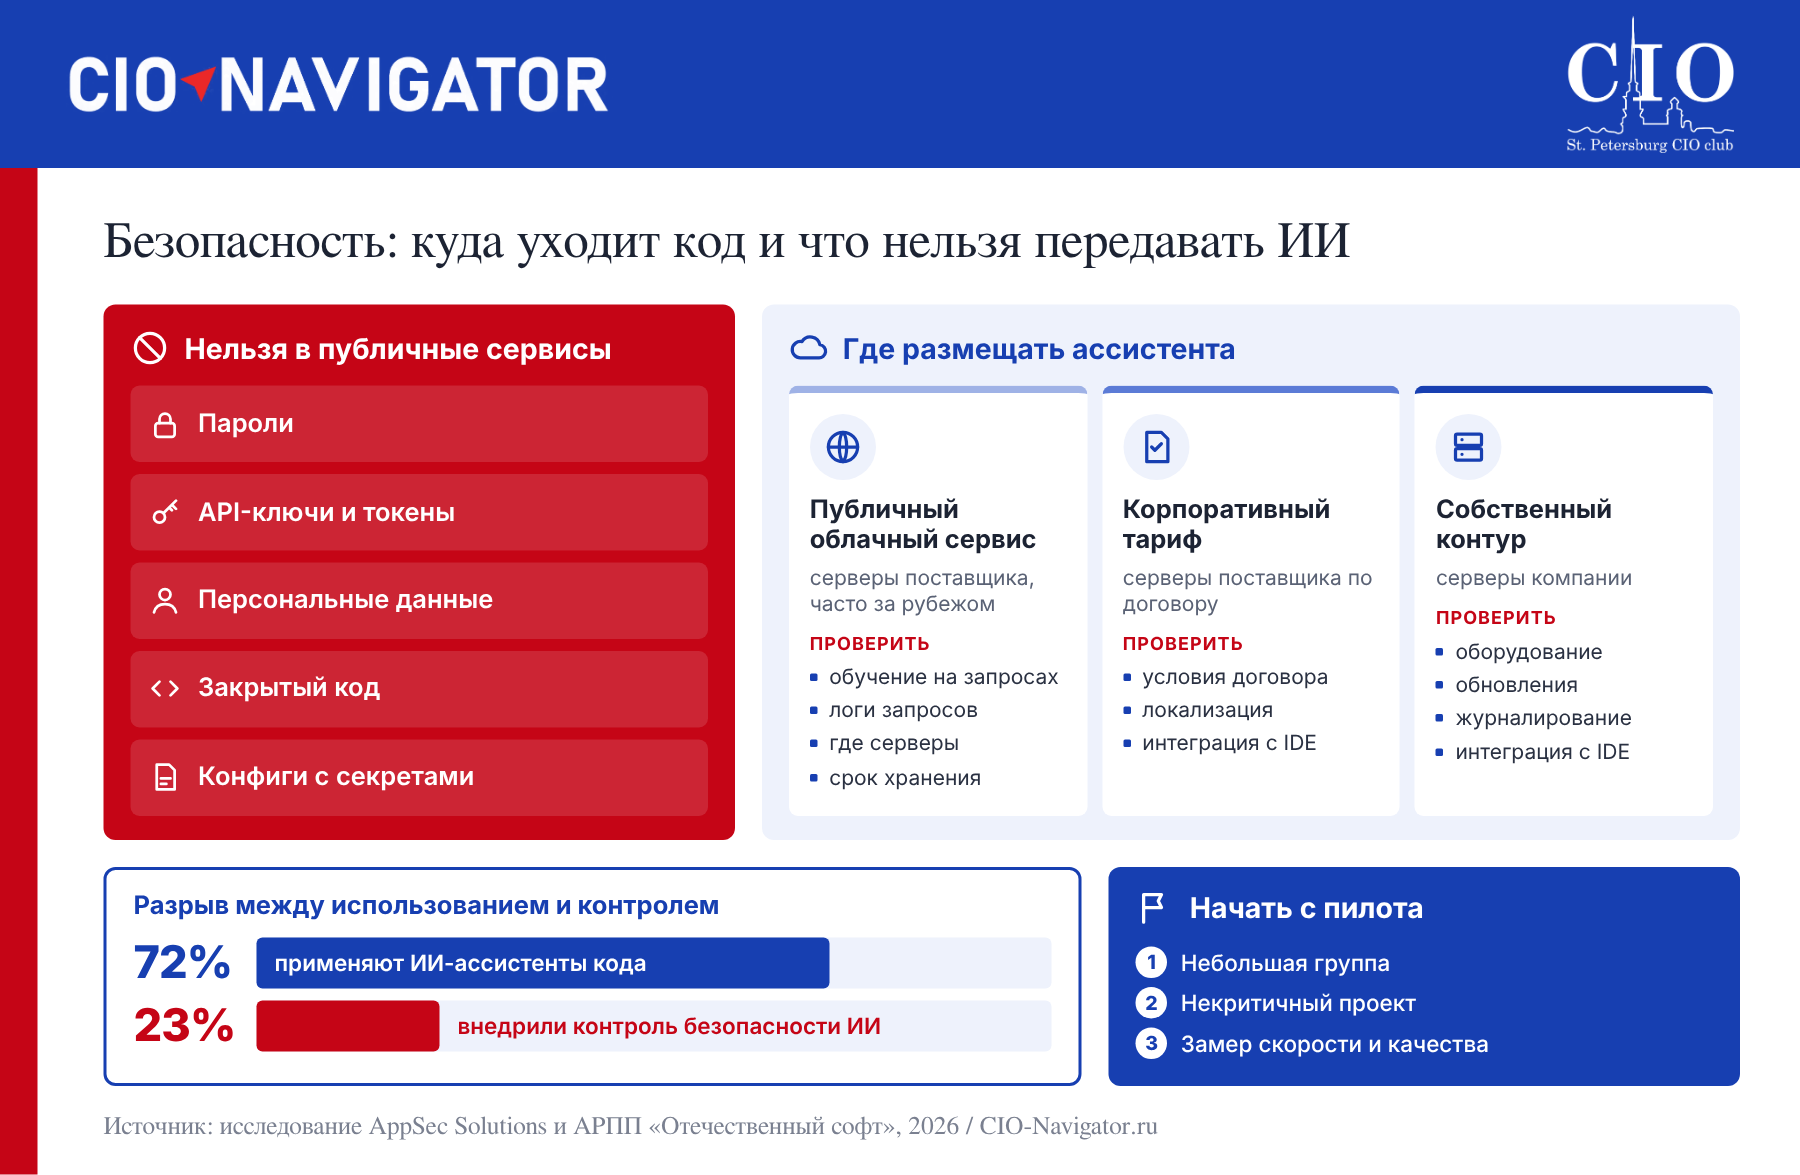
Мы рекомендуем начинать с пилота на ограниченной группе и некритичном проекте, а не с приказа для всех. Пилот покажет, какие правила приживаются в вашем стеке, а какие остаются на бумаге. При этом строгий регламент избыточен для учебных и исследовательских задач без доступа к внутренним данным: там достаточно базового запрета на передачу секретов.
Весенний опрос РУССОФТ показал, что 72,85% ответивших на вопрос софтверных компаний использовали генеративный ИИ в 2025 году и планировали продолжать; при этом исследование не выявило явного экономического эффекта от его применения. Это ещё один аргумент в пользу того, чтобы на пилоте измерять не только скорость, но и качество кода и бизнес-результат.
Заключение
Главным мы считаем не выбор конкретной нейросети, а дисциплину вокруг неё: точную постановку задачи, малые шаги, обязательную проверку и понятные правила по данным. Без этой дисциплины даже сильный инструмент лишь ускоряет накопление ошибок.
Начать мы рекомендуем с одного-двух типовых сценариев: тесты, документация, шаблонный код. Затем провести пилот в небольшой команде, зафиксировать правила ревью и безопасности и по итогам решать о расширении. Результаты пилота зависят от стека, зрелости процессов и квалификации команды, поэтому ориентироваться стоит на собственные замеры, а не на заявления вендоров.