
Проблемы при программировании на ИИ. Как их эффиктивно решать.
Один сервис уверен: код на 78% написан нейросетью. Второй смотрит на тот же код и отвечает: писал человек, вероятность 62,7%. Этот пример приводит блог Skillfactory, и он не исключение. Так обычно и работают детекторы ИИ-кода.
При этом сам вопрос «писал ли это ИИ» быстро теряет смысл. По прогнозу РУССОФТ, к концу 2026 года ИИ в разработке будут использовать 92,8% российских софтверных компаний. Важнее другое: что из сгенерированного дойдёт до рабочей системы. Среди тех, кто активно пишет код с ИИ «на вайбе», вручную проверяют результат лишь 11% (опрос «Битрикс24»).
В статье разберём:
- почему детекторы ошибаются и в каких случаях они всё же полезны;
- 8 типичных проблем кода от нейросети, от выдуманных API до лицензионных ловушек;
- какие проверки встроить в CI/CD, чтобы такой код не попал в продакшн;
- как выбрать инструменты и провести пилот на собственном коде.
Рейтинга продуктов здесь не будет. Вместо него вы получите порядок действий для команды.
- Две задачи под одним запросом: определить авторство или проверить качество
- Как работают детекторы ИИ-кода
- Какие признаки анализирует детектор
- Какие инструменты встречаются на рынке
- Почему детекторы ошибаются
- Ложные срабатывания и пропуски
- Устаревание моделей и простой обход
- Когда детектор всё же уместен
- Топ-8 типичных проблем кода, созданного нейросетью
- Как проверять код от ИИ: порядок для команды
- Функциональная проверка и тесты
- Проверка контекста и намерений
- Зависимости и цепочка поставок
- Статический анализ и проверка безопасности
- Автоматизация в CI/CD
- ИИ как инструмент проверки: что умеют ИИ-ревьюеры и где их границы
- Безопасность данных и регуляторные требования
- Как выбрать инструменты для проверки ИИ-кода
- Как провести пилот перед закупкой
- Заключение
Две задачи под одним запросом: определить авторство или проверить качество
У бизнеса за каждой задачей стоит свой вопрос. Задача детекции — узнавать, кто автор строки. Контроль качества отвечает на вопрос «можно ли выпускать эту версию».

Различия удобно свести в таблицу:
| Задача | Вопрос, на который отвечает | Кому нужна | Результат | Надёжность |
|---|---|---|---|---|
| Детекция происхождения | Написан ли фрагмент нейросетью | Преподавателям, техническим интервьюерам, авторам внутренней политики | Процент сходства с генерацией | Низкая: оценка вероятностная, обходится ручной правкой |
| Проверка сгенерированных изменений | Соответствует ли доработка требованиям | Командам программирования, службе ИБ, владельцам систем | Перечень дефектов и уязвимых мест, решение о слиянии | Выше: результаты воспроизводимы и опираются на факты |
В корпоративной разработке вопрос «кто написал строку» вторичен. Первичен вопрос о том, отвечает ли реализация ожиданиям к функциональности, архитектуре и защите. Строку, набранную вручную, оценивают по тем же правилам.
Возникает резонное возражение: если политика компании запрещает ассистенты, разве детектор не нужен? Нужен меньше, чем кажется. Его вывод не даёт доказательной базы, поэтому запрет поддерживают техническими мерами: блокировкой внешних сервисов на уровне сети, перечнем разрешённых расширений IDE, шлюзами качества. Мы рассматриваем детекцию как инструмент для разговора, и она не нужна там, где процессы уже отлавливают дефекты независимо от авторства.
Есть и ещё один довод в пользу такого подхода. Разработчики используют ассистентов массово: по опросу Stack Overflow Developer Survey 2025, их применяют или планируют применять 84% опрошенных. Поэтому запрет на уровне оценки авторства обычно проигрывает управляемому и прозрачному процессу контроля.
Российский рынок движется в ту же сторону. Весенний опрос РУССОФТ показал, что среди ответивших софтверных компаний 72,85% применяли генеративный ИИ в разработке в 2025 году и намерены продолжить, а ещё 20,35% планировали начать в 2026 году. Ассоциация прогнозирует, что к концу 2026 года ИИ в разработке будут использовать 92,8% российских софтверных компаний.
Результат детектора нельзя использовать как основание для дисциплинарных решений. Ложное срабатывание на аккуратной работе сотрудника обходится дороже, чем пропущенная генерация.
Как работают детекторы ИИ-кода
Типовой классификатор построен на модели машинного обучения. Её обучают на размеченных наборах: часть примеров написана людьми, часть создана генераторами. Загруженный текст преобразуется в признаки, например в последовательность токенов. Токеном может быть целое слово, например «тесто», его часть, символ или специальный маркер. Конкретное разбиение зависит от токенизатора, поэтому токен не обязательно совпадает с ключевым словом, именем или оператором. Затем модель оценивает статистические признаки и выдаёт вероятность, например «70% ИИ», а подозрительные участки часто подсвечиваются цветом в виде тепловой карты.
Классификатор не понимает смысла программы и не запускает её. Он сравнивает форму со знакомыми образцами. О том, работает ли программа правильно, такой отчёт ничего не сообщает.
Какие признаки анализирует детектор
Набор сигналов у разных поставщиков свой, но чаще всего в расчёт идут такие признаки:
- единообразное форматирование и одинаковые отступы во всех блоках;
- шаблонные имена вроде processData, tempValue, result, которые подходят к любой задаче;
- избыток очевидных комментариев или, наоборот, «стерильный» текст без следов работы автора;
- избыточные условия и валидации в одних местах и их отсутствие там, где они действительно нужны;
- игнорирование принятых в проекте библиотек логирования и подхода к обработке ошибок.
Каждый из этих признаков встречается и у аккуратного разработчика. Форматтер, единый стиль команды и привычка комментировать дают ту же картину, что и генерация.
Есть и ещё одно ограничение: детектор не понимает контекста проекта. Он не знает, какие библиотеки и подходы приняты в команде, и не видит истории дефектов, поэтому оценивает только внешнюю форму фрагмента.
Какие инструменты встречаются на рынке
Продукты этого класса делятся на два типа. Первый составляют онлайн-сервисы с загрузкой файла: MyDetector, LearnFast.ai, CudekAI, Decopy.ai, aicodedetector.org. Второй включает открытые утилиты командной строки, которые запускаются на рабочей станции и не отправляют исходники в сеть.
Заявления о точности стоит воспринимать как сведения от разработчика. Например, MyDetector указывает на своём сайте точность более 95% и там же оговаривает, что ни один подобный продукт не может быть уверен на 100%. Перед использованием любого из них рекомендуем уточнить поддерживаемые языки и политику обработки информации на официальном сайте.
| Тип | Где выполняется анализ | Что выдаёт | Риск для конфиденциальности |
|---|---|---|---|
| Онлайн-сервис | На серверах поставщика | Процент вероятности генерации, подсветку участков, текстовое пояснение | Высокий: исходный текст покидает периметр компании |
| Локальная утилита | На компьютере пользователя или во внутреннем контуре | Оценку по файлу или фрагменту, чаще без пояснений | Низкий, если утилита не обращается к внешним адресам |
Почему детекторы ошибаются
Причины ошибок заложены в самой постановке: классификатор ищет статистическое сходство, а не факт генерации. Сходство зависит от стиля, языка, длины текста и версии генератора.
Разберём эти причины по отдельности. Любая цифра в отчёте означает вероятность, а не установленный факт.
Ложные срабатывания и пропуски
Ложное срабатывание происходит, когда работу человека принимают за генерацию. Чаще всего так бывает после автоформатирования: Prettier, Black и gofmt приводят оформление к единому виду, а стандартные идиомы языка выглядят шаблонно. Обратная ситуация тоже типична: сгенерированный фрагмент после правки разработчиком проходит незамеченным.
Показательный пример приводит блог Skillfactory. Решение задачи с Codewars, которое, по оценке авторов, писал человек, одна площадка сочла сгенерированным на 78%, а другая посчитала человеческим с вероятностью 62,7%.
Типичные ситуации собраны в таблице:
| Ситуация | Типичный результат детектора | Почему |
|---|---|---|
| Работа после форматтера и линтера | Высокая вероятность генерации | Ровный стиль совпадает с признаками из обучающей выборки |
| Созданный ассистентом и отредактированный вручную фрагмент | Низкая вероятность генерации | Правка разрушает статистические признаки |
| Короткий фрагмент на несколько строк | Случайный разброс оценок | Признаков слишком мало для устойчивого вывода |
| Менее распространённый язык | Нестабильная точность | В обучающей выборке мало примеров на этом языке |
Устаревание моделей и простой обход
Классификатор учится на выдаче генераторов, доступных на момент сбора выборки. Новые модели пишут иначе, и точность на их текстах снижается, пока набор не обновят. Поставщики редко сообщают, на каких генераторах обучен их продукт.
Обойти оценку несложно: достаточно переименовать переменные, заменить структуру циклов и изменить стиль комментариев. ИТ-сообщество публиковало собственные испытания таких сервисов, и результаты противоречат друг другу: в одном эксперименте система дала фрагменту 92% вероятности генерации и в пояснении назвала его человеческим. Здесь технология не помогает, и способа надёжно закрыть этот разрыв настройкой мы не видим.
Когда детектор всё же уместен
Узкие сценарии, где оценка происхождения полезна, всё же есть:
- учебные задания и тестовое задание при найме: высокий процент становится поводом попросить кандидата объяснить логику решения, а не вердиктом;
- первичная разметка поставок от подрядчика, чтобы определить, какие модули отправить на ревью в первую очередь;
- оценка доли ассистентов в репозитории при подготовке внутренней политики.
Во всех трёх случаях вывод делает человек после разговора или ревью. Ещё один допустимый сценарий: высокий процент у функции с необычной структурой служит поводом поискать совпадения в открытых репозиториях и проверить лицензию первоисточника.
Если оценка происхождения всё же нужна, фрагмент загружают целиком, без сокращений, и прогоняют через два или три сервиса. Сравнивают не только итоговый процент, но и подсвеченные участки. Когда оценки разных сервисов заметно расходятся, однозначный вывод сделать нельзя, и фрагмент отправляют на обычное ревью.
Перед загрузкой исходников в онлайн-детектор стоит сверить это действие с договором подряда, режимом коммерческой тайны и требованиями к обработке персональных данных. Тестовые наборы и конфигурации нередко содержат реальные записи клиентов и ключи доступа.
Топ-8 типичных проблем кода, созданного нейросетью
Реализация от ассистента выглядит правдоподобно: аккуратные имена, комментарии, привычная структура. Поэтому ошибки в ней маскируются лучше, чем в небрежной ручной работе, и ревьюер склонен доверять увиденному.
Эту двойственность подтверждают и сами участники рынка. Опрос Ассоциации ФинТех показал, что 45% участников считают, что ИИ заметно ускоряет разработку, а 41% одновременно отмечают снижение качества решений. В том же опросе 86% компаний назвали системное мышление и понимание архитектуры ключевыми требованиями к ИТ-специалистам.
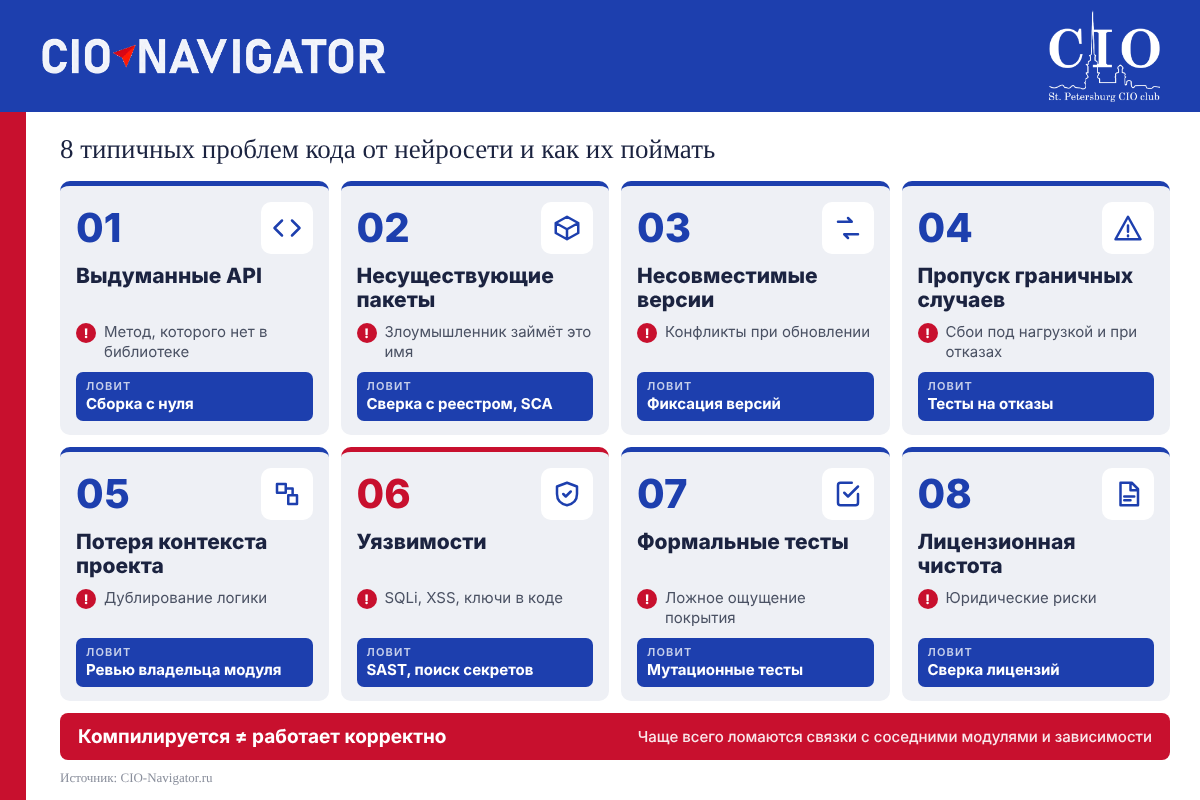
Основные классы проблем и способы их обнаружить собраны ниже:
| Проблема | Как проявляется | Чем опасна | Как обнаружить |
|---|---|---|---|
| Выдуманные функции и методы (галлюцинации API) | Вызов метода, которого нет в используемой версии библиотеки | Сбой при сборке или в редкой ветке выполнения | Сборка с нуля, сверка с документацией |
| Несуществующие или устаревшие пакеты | Модель предлагает имя пакета, которого нет в реестре | Злоумышленник регистрирует пакет с таким именем и внедряет вредоносную логику | Сверка с официальным реестром, SCA |
| Несовместимые версии | Части реализации рассчитаны на разные мажорные версии библиотек | Нестабильная работа, конфликты при обновлении | Фиксация версий, сборка в чистом окружении |
| Пропуск граничных случаев | Нет обработки пустых данных, тайм-аутов, повторных запросов | Сбои под нагрузкой и при отказе внешних систем | Тесты на неправильный ввод и отказы |
| Потеря контекста проекта | Свой способ логирования, обход общих модулей | Нарушение архитектуры, дублирование логики | Ревью с участием владельца модуля |
| Уязвимости | SQL-инъекции, XSS, жёстко прописанные пароли и ключи, лишние привилегии в Dockerfile и пайплайнах | Утечка сведений, захват среды сборки | SAST, поиск секретов, анализ конфигураций |
| Формальные тесты | Утверждения без смысла, заведомо истинные условия, удалённые вместо исправления сценарии | Ложное ощущение покрытия | Мутационное тестирование, ревью тестового набора |
| Лицензионная чистота | Совпадение с публичным проектом под несовместимой лицензией | Юридические риски для продукта | Поиск совпадений, сверка лицензий в SCA |
На практике чаще всего ломается связка с соседним модулем и зависимости: созданная ассистентом функция корректна сама по себе, но иначе обрабатывает ошибки или тянет новую библиотеку. Компилируемость не означает корректность.
Есть и риск вайбкодинга. Так называют подход, при котором код принимают, не вчитываясь в детали. Для прототипа или одноразового скрипта это допустимо, но в продукте, который будет жить годами, быстро накапливаются дублирование логики и разные способы решать одну задачу.
Опрос «Битрикс24» среди активных практиков вайбкодинга показал, что 54% проверяют сгенерированный код на уязвимости средствами ИИ, а ручной аудит проводят лишь 11%. То же исследование отмечает, что среди участников, чьими приложениями пользуются клиенты, ручную проверку проводят 14%.
Отдельно стоит следить за удалёнными или отключёнными тестовыми сценариями в pull request. Ассистент нередко «чинит» падающую сборку именно так.
Поэтому ручной проверки в первую очередь требуют участки, где обрабатывается ввод пользователя, выполняется авторизация и строятся запросы к базе данных. Модель воспроизводит паттерны из обучающих данных, а среди них встречается и уязвимый код.
Как проверять код от ИИ: порядок для команды
Порядок ниже опирается на рекомендации документации GitHub по контролю сгенерированных правок и дополнен практикой безопасной разработки.
Шаги идут от дешёвых автоматических этапов к трудоёмким ручным. Каждый следующий рассчитан на то, что предыдущий уже пройден.
Качество проверки зависит и от постановки задачи ассистенту. Если на входе указать версии языка и библиотек, ожидаемые входные и выходные данные и запретить лишние правки, число несовместимостей и выдуманных вызовов заметно снижается.
Функциональная проверка и тесты
Первым делом новую версию собирают с нуля в чистом окружении и прогоняют существующие тесты. Затем вручную проходят основные сценарии и неправильный ввод: пустые поля, слишком длинные значения, повторную отправку. Отдельно смотрят регрессию, то есть не сломались ли старые возможности. В крупных проектах сценарии и результаты проверок можно учитывать в системах управления тестированием.
Если базовый набор пройден, имеет смысл оценить качество самих тестов:
- модульные, интеграционные и сквозные сценарии должны покрывать изменённую логику на всех уровнях;
- мутационное тестирование, это значит намеренно вносить ошибки и смотреть, ловит ли их набор;
- дифференциальное тестирование, это значит запускать старую и новую версии на одних входных значениях и сравнивать вывод.
Проверка контекста и намерений
Следующий вопрос: решает ли доработка ту задачу, что поставлена в постановке, и соответствует ли она архитектуре и внутренним стандартам. Если команда фиксирует требования в системах управления требованиями, ревьюеру полезно сверить изменения с их актуальной версией. Ревьюер должен понимать каждую строку, потому что действует принцип «кто принял в ветку, тот отвечает».
Ревьюеру помогают такие вопросы:
- решает ли реализация исходную задачу или похожую на неё;
- какие допущения о бизнес-логике и поведении пользователей сделала модель;
- дублирует ли новая логика уже существующие в проекте модули;
- можно ли разбить реализацию на небольшие части, которые легко изолировать при отладке;
- проще ли доработать предложенный вариант, чем переписать его заново.
Если ассистент меняет код ради падающего теста, стоит спросить, почему выбрано именно такое изменение, и потребовать вариант исправления, при котором тест остаётся. Так выявляется подмена причины симптомом. Для отладки полезно передавать модели разницу между рабочим и падающим случаем и просить сначала назвать гипотезы, а не сразу править код.
Зависимости и цепочка поставок
Для каждого нового пакета сверяют четыре вещи: существует ли он, какая версия подключена, под какой лицензией распространяется и есть ли известные уязвимости. Анализ состава компонентов (SCA) — это автоматическая сверка сторонних библиотек с базами уязвимых версий, в том числе с CVE и БДУ ФСТЭК России. Регулярный запуск SCA позволяет быстро реагировать на новые уязвимости в уже подключённых библиотеках.
Перечень компонентов важен и для регуляторных процедур. Для сертификации средств защиты по решениям, выданным ФСТЭК после 1 августа 2026 года, применяется методика выявления уязвимостей и недекларированных возможностей. В ней для перечня компонентов предусмотрен машиночитаемый формат CycloneDX в JSON.
Лицензии проверяют отдельно. Например, зависимость под AGPL-3.0 в проекте с лицензией MIT или пакет без заявленной лицензии создают юридический риск. Совпадения сгенерированного фрагмента с публичным кодом тоже стоит искать до слияния: такую функцию предлагают, например, средства GitHub Copilot.
Пакет, предложенный нейросетью, обязательно сверяют с официальным реестром: PyPI, npm, Maven Central или внутренним зеркалом. Похожее на известное имя, свежая дата публикации и малое число загрузок служат поводом остановить слияние.
Статический анализ и проверка безопасности
SAST — это анализ исходного текста программы без запуска на типовые уязвимости: инъекции, небезопасную работу с файлами, ошибки обработки ввода. Из распространённых анализаторов можно назвать SonarQube, CodeQL и Semgrep, из линтеров ESLint для JavaScript. Среди российских разработок есть PVS-Studio и Solar appScreener; поддерживаемые языки и варианты поставки лучше уточнять на официальных сайтах.
Секреты ищут отдельно: пароли, токены и ключи находят специализированные сканеры, например Gitleaks, и встроенные функции платформ хранения репозиториев. Мы рекомендуем начинать с анализаторов, которые уже есть в компании: правила под них настроены, а результаты понятны службе ИБ. Новый продукт имеет смысл закупать, когда видны конкретные пробелы в покрытии.
Автоматизация в CI/CD
Ручные шаги со временем начинают пропускать, поэтому ключевые этапы контроля переносят в конвейер CI/CD. Слияние ветки разрешается только после прохождения шлюзов качества.
Обязательные шлюзы качества перед слиянием выглядят так:
- прохождение всех тестов, включая регрессионные;
- порог покрытия для изменённых строк, согласованный командой;
- SAST без новых критичных замечаний;
- SCA без компонентов с критичными уязвимостями и запрещёнными лицензиями;
- поиск секретов в новых коммитах и их истории;
- одобрение минимум одного человека, который не был автором запроса на слияние.

Статистика AppSec Solutions показывает масштаб задачи контроля: в 4214 кодовых базах объёмом около 510 млн строк выявили более 3,1 млн уязвимостей. За год число находок выросло на 70%, а очередь на их разбор — примерно на 18%; эти цифры относятся ко всему анализируемому коду, а не только к фрагментам, созданным ИИ.
Правила использования ассистентов полезно закрепить в документе репозитория, например в файле CONTRIBUTING.md: что допустимо, как помечать сгенерированные изменения, какие проверки обязательны. Удачные запросы и приёмы стоит собирать и делиться ими внутри команды.
ИИ как инструмент проверки: что умеют ИИ-ревьюеры и где их границы
Здесь искусственный интеллект не определяет авторство, а сам разбирает pull request. Типовые возможности: построчные комментарии, поиск логических ошибок, предложения тестов и документации, разделение замечаний на дефекты и необязательные улучшения.
К этому классу относятся инструменты с ИИ для анализа кода: GitHub Copilot code review, CodeRabbit, Qodo, Snyk Code и ИИ-функции в IDE. Состав возможностей и условия доступа из России меняются, поэтому их лучше уточнить у поставщика перед пилотом.
Различия с классическими анализаторами видны по пяти параметрам:
| Параметр | Классический анализатор | ИИ-ревьюер |
|---|---|---|
| Воспроизводимость результата | Одинаковый вывод на одних входных значениях | Ответ может отличаться между запусками |
| Объяснение причины | Ссылка на правило и класс уязвимости (CWE) | Развёрнутое пояснение на естественном языке, не всегда точное |
| Ложные срабатывания | Предсказуемы, гасятся настройкой правил | Возможны уверенные, но неверные замечания |
| Понимание бизнес-логики | Отсутствует | Частичное, в пределах переданного контекста |
| Требования к передаче кода | Обычно работает локально | Часто требует отправки исходников в облако поставщика |
Возникает вопрос: зачем ревью человеком, если есть автоматический ревьюер? Модель даёт первичную оценку и экономит внимание на очевидном, но не отвечает за последствия слияния. Ответственность за принятую доработку остаётся за командой.
Встречается и подход «генерирует одна модель, проверяет другая». Он помогает поймать часть ошибок, однако не заменяет сценарии тестирования и статический анализ: обе модели могут одинаково ошибаться в редких ситуациях.
Безопасность данных и регуляторные требования
Передача исходников во внешний облачный сервис создаёт риск утечки коммерческой тайны. Тестовые наборы часто содержат выгрузки из рабочих баз, а значит, и персональные данные, обработку которых регулирует 152-ФЗ. Закон включает передачу и предоставление доступа к персональным данным в понятие обработки.
Для бизнеса этот риск уже стал практическим барьером. В опросе Ассоциации ФинТех 65% российских финтех-компаний назвали требования ИБ препятствием для масштабирования ИИ, а 53% указали на ограничения при передаче данных внешним сервисам. Это результаты опроса финансовых компаний, а не оценка всего рынка.
Для процессов безопасной разработки в качестве ориентира можно использовать ГОСТ Р 56939-2024 «Защита информации. Разработка безопасного программного обеспечения. Общие требования»: стандарт действует с 20 декабря 2024 года и устанавливает общие требования к созданию безопасного ПО и устранению уязвимостей. Требования ФСТЭК к уровням доверия относятся к средствам технической защиты информации и средствам обеспечения безопасности ИТ, применяемым для защиты информации ограниченного доступа и значимых объектов КИИ; они утверждены приказом № 76. В 2025 году регулятор обновил отдельные положения приказа. Актуальные редакции документов следует сверять на официальных ресурсах регулятора.
Для госструктур и заказчиков значимых объектов КИИ действуют дополнительные ограничения. Подробнее о критериях можно прочитать в правилах категорирования объектов КИИ РФ. С 1 января 2025 года Указ Президента № 166 запрещает органам государственной власти и заказчикам использовать иностранное ПО на принадлежащих им значимых объектах КИИ, если иное не установлено федеральным законом. Этот запрет касается использования ПО на таких объектах и сам по себе не устанавливает общего запрета на передачу исходников в зарубежное облако. Передачу конкретного кода отдельно оценивают с учётом категории сведений, статуса системы, договорных обязательств и применимых требований защиты. Для значимого объекта КИИ выбор средства и способа его развёртывания нужно проверять с ответственными за ИБ: локальная установка может снизить риск передачи кода внешнему поставщику, но сама по себе не подтверждает соответствие всем требованиям.
Перед закупкой поставщику рекомендуем задать обязательные вопросы:
- где физически обрабатываются исходники и в какой юрисдикции находятся серверы;
- хранятся ли загруженные фрагменты и используются ли они для дообучения;
- есть ли локальная или закрытая установка без обращения к внешним адресам;
- ведётся ли журнал действий и как разграничен доступ к результатам анализа.
Загрузку рабочих исходников в публичные чат-боты разумно запретить до появления внутренней политики. В ней перечисляют разрешённые сервисы, категории информации, которую нельзя передавать, и порядок согласования исключений.
Как выбрать инструменты для проверки ИИ-кода
Выбор начинается с задачи, а не с названия продукта. Ниже критерии, которые стоит пройти по порядку:
- Задача: определение происхождения, ревью или безопасность.
- Поддерживаемые языки и фреймворки вашего стека.
- Вариант развёртывания: публичное облако, частное облако, локальная установка.
- Интеграция с IDE, системой контроля версий и конвейером CI/CD.
- Объяснимость замечаний: ссылка на правило, строку и способ исправления.
- Уровень ложных срабатываний на ваших репозиториях, а не на демонстрационных примерах.
- Соответствие требованиям ИБ и регуляторов.
- Лицензирование и доступность для российских компаний, включая поддержку и обновления.
Соотнести сценарий и класс решения помогает таблица:
| Сценарий компании | Какой класс инструмента рассмотреть |
|---|---|
| Нужно закрыть типовые уязвимости в собственной разработке | SAST и поиск секретов |
| Много сторонних библиотек и открытых компонентов | SCA с формированием SBOM |
| Ревьюеры не успевают разбирать запросы на слияние | Автоматический ревьюер на основе нейросети в закрытом контуре или с допустимым порядком обработки |
| Объект КИИ или госсистема | Отечественные средства с локальной установкой и сертификатом, если он требуется |
| Подготовка политики использования ассистентов | Локальная утилита оценки происхождения для разовой выборки |
Как провести пилот перед закупкой
Пилот нужен, чтобы сравнить кандидатов в одинаковых условиях. Мы советуем оценивать продукты на собственном коде, а не по данным вендора: демонстрационные примеры почти всегда подобраны под сильные стороны продукта.
Без такой проверки эффект часто остаётся неизмеренным. Исследование IT_ONE совместно с фондом «Сколково» и «Сколтехом» показало, что лишь четверть крупных компаний измеряют специальными метриками реальный эффект от внедрения ИИ в процессы разработки.
Порядок пилота выглядит так:
- Выбрать 2–3 репозитория разной сложности, включая устаревший модуль.
- Собрать эталонный набор известных дефектов и уязвимостей из истории инцидентов и прошлых аудитов.
- Прогнать кандидатов и сравнить найденное, пропущенное и ложные срабатывания.
- Оценить нагрузку на ревьюеров: сколько замечаний приходится разбирать вручную.
- Подтвердить выполнение условий ИБ: место обработки, журналирование, разграничение доступа.
- Зафиксировать внутреннюю политику использования ассистентов по итогам пилота.
Метрики удобно вести в общей таблице, значения заполняются по результатам прогона:
| Метрика | Что измеряет | Как считать |
|---|---|---|
| Доля найденных эталонных дефектов | Полнота | Найдено из эталона, делённое на общее число в эталоне |
| Доля ложных срабатываний | Точность | Неверные замечания, делённые на все замечания |
| Время на разбор замечаний | Нагрузка на команду | Часы ревьюеров на один запрос на слияние |
| Время прогона в конвейере | Влияние на сборку | Минуты от запуска до отчёта |
| Соответствие политике ИБ | Допустимость | Выполнено или не выполнено по каждому пункту |
Любые рекомендации из этого материала, включая наши, требуют подтверждения пилотом в вашей среде.
Заключение
Мы считаем главным не установление авторства, а контроль, через который одинаково проходит работа человека и нейросети. Тогда вопрос о происхождении строки теряет остроту: дефект будет найден независимо от того, кто его внёс.
Начинать рекомендуем с внутренней политики использования ассистентов. Затем стоит закрепить обязательные шлюзы качества в CI/CD и контроль передачи исходников во внешние сервисы, а уже после этого выходить на пилот. Оценку происхождения разумно оставить вспомогательным сигналом для разговора. Решения принимает команда, которая понимает каждую принятую строку.